An ordinary decoder binarises the image, samples a grid and either returns a string or nothing. qrsalvage takes the same problem apart into steps that can each be measured — because a QR code carries, inside itself, a few hundred cells whose correct value is fixed by the specification. Everything below is scored against those.
Ein gewöhnlicher Decoder binarisiert das Bild, tastet ein Gitter ab und liefert entweder eine Zeichenfolge oder nichts. qrsalvage zerlegt dasselbe Problem in einzeln messbare Schritte — denn ein QR-Code trägt einige hundert Zellen in sich, deren korrekter Wert von der Spezifikation festgelegt ist. Alles Folgende wird an ihnen bewertet.
01The known cellsDie bekannten Zellen
Finder patterns, separators, timing rows, alignment patterns and one always-dark module are not data. The standard fixes them, so their true values are known before anything is read. In a version 3 code that is 244 of 841 cells — about 29 %.
Suchmuster, Trennbereiche, Taktreihen, Ausrichtungsmuster und ein stets dunkles Modul sind keine Daten. Der Standard legt sie fest; ihre tatsächlichen Werte sind daher bekannt, bevor etwas gelesen wird. Bei einem Code der Version 3 sind das 244 von 841 Zellen — etwa 29 %.
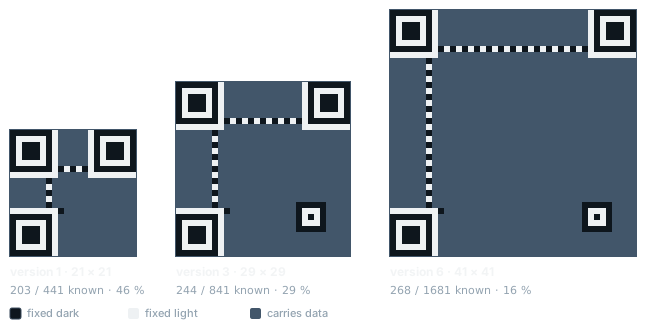
structure_mask the solver scores itself with. The fixed cells cluster around the border — which is why the uncertainty model cannot be estimated from them alone, and why §03 has to add a second term for the middle.
Die Referenz, an der das gesamte Verfahren kalibriert wird. Direkt aus derselben structure_mask gezeichnet, an der der Solver sich bewertet. Die festgelegten Zellen liegen gehäuft am Rand — deshalb kann das Unsicherheitsmodell nicht allein aus ihnen geschätzt werden und §03 muss einen zweiten Term für die Mitte ergänzen.
That is the whole idea. Every later step — the brightness model, the grid, the version, the polarity — produces a number that can be checked against cells whose answer is already settled. Nothing has to be believed.
Das ist die ganze Idee. Jeder spätere Schritt — Helligkeitsmodell, Gitter, Version und Polarität — erzeugt eine Zahl, die sich an Zellen mit bereits feststehender Antwort prüfen lässt. Nichts muss einfach geglaubt werden.
02Two brightness fieldsZwei Helligkeitsfelder
On a curved, unevenly lit surface there is no single threshold that separates dark from light. Worse, the dark level and the light level drift by different amounts: a glare highlight lifts white paper far more than it lifts black ink.
So two independent quadratic fields are fitted by ordinary least squares, one through the known-dark cells and one through the known-light ones:
Auf einer gewölbten, ungleichmäßig beleuchteten Fläche gibt es keinen einzelnen Schwellenwert, der dunkel von hell trennt. Schlimmer noch: Dunkel- und Hellniveau driften unterschiedlich stark; ein Glanzlicht hebt weißes Papier weit stärker an als schwarze Tinte.
Deshalb werden mit gewöhnlicher kleinster-Quadrate-Schätzung zwei unabhängige quadratische Felder angepasst, eines durch die bekanntermaßen dunklen und eines durch die bekanntermaßen hellen Zellen:
L(r,c) = b₀ + b₁r + b₂c + b₃r² + b₄c² + b₅rc
a = argmin Σknown dark ( D(r,c) − mean(r,c) )² r, c — module row and column · mean(r,c) — measured grey value of that cell
six coefficients each, solved from roughly 120 known cells, so heavily overdetermined r, c — Modulzeile und -spalte · mean(r,c) — gemessener Grauwert dieser Zelle
je sechs Koeffizienten, aus ungefähr 120 bekannten Zellen gelöst und damit stark überbestimmt
The threshold is their midpoint and the contrast their difference, both varying across the code:
Der Schwellenwert ist ihr Mittelpunkt und der Kontrast ihre Differenz; beide verändern sich über den Code:
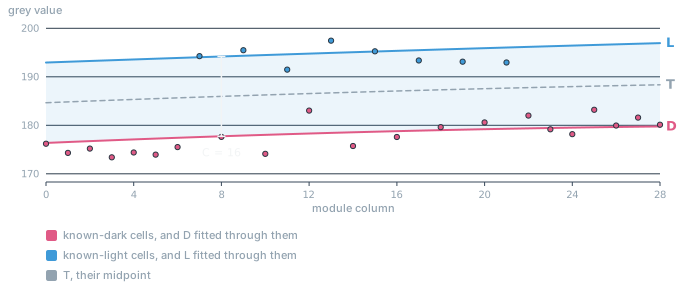
fixtures/engraved-curved-hard.png: the two levels are separated by roughly sixteen grey values out of 255, and they drift across the code together. A single global threshold has to be right to within a few grey values everywhere at once; the midpoint of two fitted fields does not.
Beide Niveaus, über eine Zeile gemessen. Zeile 6 ist die einzige Zeile mit einer bekannten Zelle in jeder Spalte — Suchmuster, Trennbereich, dann das wechselnde Taktmuster. So lassen sich beide Felder an echten Messwerten statt an Extrapolationen zeigen. Aus fixtures/engraved-curved-hard.png: Die Niveaus liegen nur ungefähr sechzehn von 255 Grauwerten auseinander und driften gemeinsam über den Code. Ein einzelner globaler Schwellenwert müsste überall zugleich auf wenige Grauwerte genau stimmen; der Mittelpunkt zweier angepasster Felder muss das nicht.
03A probability per moduleEine Wahrscheinlichkeit je Modul
A cell is not classified, it is scored. Two Gaussians of equal width, one centred on the dark level and one on the light, give a log-odds that is linear in the measurement:
Eine Zelle wird nicht klassifiziert, sondern bewertet. Zwei gleich breite Gaußverteilungen, eine um das Dunkelniveau und eine um das Hellniveau zentriert, ergeben logarithmische Chancen, die linear vom Messwert abhängen:
P(dark) = 1 / ( 1 + e−ℓ ) x = mean / C, D̂ = D / C, L̂ = L / C — all normalised by the local contrast
so a faint code and a crisp one are measured on the same scalex = mean / C, D̂ = D / C, L̂ = L / C — alle durch den lokalen Kontrast normiert
so werden ein blasser und ein scharfer Code auf derselben Skala gemessen
Why σ is a field and not a numberWarum σ ein Feld und keine Zahl ist
The obvious estimate of σ is the scatter of the known cells around their own fitted level. It is also not enough, and the failure is instructive: the known cells all sit around the border of the code. When they happen to be clean, σ comes out small and the model becomes confident about the data cells in the middle with no grounds for it.
This was observed on a synthetic case that placed the grid perfectly, reported zero wrong known cells and zero uncertain cells — and would not decode. The solver had nothing to probe because nothing looked doubtful.
So a second, independent term is added: each cell's own internal spread. A module whose interior is uniform is trustworthy; one that is half dark and half light is not, and that holds in the middle where no known cell reaches.
Die naheliegende Schätzung für σ ist die Streuung der bekannten Zellen um ihr jeweils angepasstes Niveau. Auch das reicht nicht: Die bekannten Zellen liegen sämtlich am Rand des Codes. Sind sie zufällig sauber, wird σ klein und das Modell ist ohne Grundlage von den Datenzellen in der Mitte überzeugt.
Das zeigte ein synthetischer Fall, der das Gitter perfekt platzierte, null falsche bekannte und null unsichere Zellen meldete — sich aber nicht decodieren ließ. Der Solver hatte nichts nachzutasten, weil nichts zweifelhaft aussah.
Deshalb kommt ein zweiter, unabhängiger Term hinzu: die innere Streuung jeder Zelle. Ein Modul mit gleichmäßigem Inneren ist vertrauenswürdig; eines, das halb dunkel und halb hell ist, ist es nicht. Das gilt auch in der Mitte, die keine bekannte Zelle erreicht.
s(r,c) — standard deviation of the pixels inside that one cell
s̄ — median of s over the known cells, the baseline a dot-raster engraving gives everything
k = 1.5 · only the excess over the baseline counts, or the signal is flattened σ₀ — Streuung der bekannten Zellen um ihr angepasstes Niveau
s(r,c) — Standardabweichung der Pixel innerhalb dieser Zelle
s̄ — Median von s über die bekannten Zellen, die Grundstreuung einer Punktraster-Gravur
k = 1.5 · nur der Überschuss über die Grundstreuung zählt, sonst wird das Signal eingeebnet
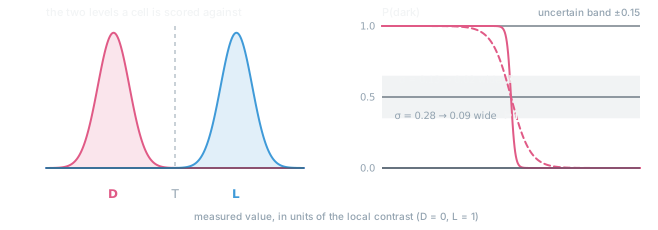
fixtures/engraved-curved-hard.png. By eye the two are almost the same curve, so the figure marks the quantity that matters instead: how wide a range of measurements the cell reports as undecided. It is 0.02 of the local contrast against 0.09 — a factor of nearly six in how readily a cell admits doubt, and therefore in whether the search ever looks at it. The shaded strip is the ±0.15 the solver counts as uncertain.
Was σ tatsächlich bringt. Beide Kurven zeigen dieselbe Formel für denselben Messwert; nur die Streuung unterscheidet sich, entnommen an der saubersten und der verrauschtesten Zelle aus fixtures/engraved-curved-hard.png. Mit bloßem Auge sind die Kurven fast gleich, deshalb markiert die Abbildung die entscheidende Größe: wie breit der Messwertbereich ist, den die Zelle als unentschieden meldet. Er beträgt 0.02 des lokalen Kontrasts gegenüber 0.09 — ein Faktor von fast sechs darin, wie leicht eine Zelle Zweifel zulässt und damit, ob die Suche sie betrachtet. Der schattierte Streifen zeigt die ±0.15, die der Solver als unsicher zählt.
04Fitting the gridDas Gitter anpassen
A homography maps four corners onto a square. It cannot represent a cylinder — and a QR code on a light bulb is on a cylinder. The best available approximation is not analytically available, but it is findable.
Eight parameters, the four corner coordinates. The objective is the mean contrast-normalised margin over the known cells, squashed so that one badly-placed cell cannot dominate:
Eine Homografie bildet vier Ecken auf ein Quadrat ab. Sie kann keinen Zylinder darstellen — und ein QR-Code auf einer Glühbirne liegt auf einem Zylinder. Die bestmögliche Näherung lässt sich nicht analytisch angeben, aber finden.
Acht Parameter, die Koordinaten der vier Ecken. Die Zielfunktion ist der mittlere, kontrastnormierte Abstand über die bekannten Zellen, gestaucht, damit eine einzelne schlecht platzierte Zelle nicht dominieren kann:
Q = meanknown tanh( 4 · m ) maximised by coordinate descent: each coordinate is nudged by ±δ, improvements are kept,
and δ halves when a full sweep finds nothing. δ starts at 3 px and stops below 0.05 pxdurch Koordinatenabstieg maximiert: Jede Koordinate wird um ±δ verschoben, Verbesserungen bleiben erhalten,
und δ halbiert sich, wenn ein vollständiger Durchlauf nichts findet. δ beginnt bei 3 px und endet unter 0.05 px
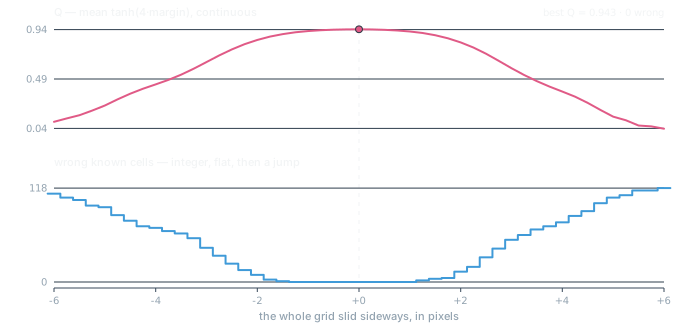
fixtures/engraved-curved-hard.png is slid sideways one pixel at a time and both quantities are recorded. Q moves for every fraction of a pixel and points back at the optimum from anywhere on the curve; the error count is flat, then jumps, and past about two pixels it is uselessly saturated. Two quantities on two scales, so two panels — never one plot with two axes.Dieselbe Bewegung, durch beide Zahlen gesehen. Das angepasste Gitter auf fixtures/engraved-curved-hard.png wird jeweils um einen Pixel seitlich verschoben und beide Größen werden aufgezeichnet. Q bewegt sich bei jedem Pixelbruchteil und weist von überall auf der Kurve zurück zum Optimum; die Fehlerzahl bleibt konstant, springt dann und ist jenseits von etwa zwei Pixeln nutzlos gesättigt. Zwei Größen auf zwei Skalen, also zwei Diagramme — nie ein Diagramm mit zwei Achsen.
On the photograph this project started with, that descent took the sampling error from 18 wrong known cells to 2, and only then did the code decode.
When the plane is not enough
A homography maps straight lines to straight lines, and four corners can only tilt the plane — they have no way to say bow. So the winning grid gets one more stage: two quadratic bows, one swept along each axis, four parameters in all. The parametrisation is deliberately the smallest one that can express what a curved surface does. A first attempt with a free 3×3 control lattice — eighteen parameters — overfitted the border: the objective is measured on the known cells, which ring the code, so the lattice bought border margin by bending the unmeasured middle, and images the flat grid solved stopped decoding. Four separable parameters cannot say "fix the border, bend the middle"; the constraint is the parametrisation itself, with no penalty weight to tune. On a photographed fabric label this stage is the difference between no result at any budget and decoding on the first attempt.
Auf dem Foto, mit dem dieses Projekt begann, senkte dieser Abstieg den Abtastfehler von 18 falschen bekannten Zellen auf 2; erst dann ließ sich der Code decodieren.
Wenn die Ebene nicht genügt
Eine Homografie bildet Geraden auf Geraden ab, und vier Ecken können die Ebene nur neigen — sie können keine Wölbung ausdrücken. Deshalb erhält das beste Gitter eine weitere Stufe: zwei quadratische Wölbungen, je eine entlang jeder Achse, insgesamt vier Parameter. Die Parametrisierung ist absichtlich die kleinste, die das Verhalten einer gekrümmten Fläche ausdrücken kann. Ein erster Versuch mit einem freien 3×3-Kontrollgitter — achtzehn Parameter — überangepasste den Rand: Die Zielfunktion wird an den bekannten Zellen gemessen, die den Code umringen. Das Gitter erkaufte Randabstand, indem es die ungemessene Mitte verbog, und Bilder, die das ebene Gitter gelöst hatte, ließen sich nicht mehr decodieren. Vier separierbare Parameter können nicht „Rand reparieren, Mitte verbiegen“ ausdrücken; die Beschränkung ist die Parametrisierung selbst, ohne einzustellendes Strafgewicht. Auf einem fotografierten Stoffetikett entscheidet diese Stufe zwischen keinem Ergebnis bei jedem Budget und Decodierung beim ersten Versuch.
05What is searched, not guessedWas gesucht statt geraten wird
Four things could be estimated from the image and are instead enumerated, because a wrong guess is invisible while a wrong candidate is obvious in the known cells.
- The version. Every candidate size gets its own grid fit. On the bulb the winner had 2 of 244 cells wrong and the runner-up 69 — the estimate from the finder width had landed between two candidates.
- The resolution. A finder is seven modules wide, so the module size follows from it. The preprocessing assumes roughly nine pixels per module; outside that band the image is rescaled — in both directions. A code can fail for being photographed too well.
- The polarity. Light-on-dark cannot be settled by looking at the finders: a finder is nested squares and so is its inverse. It is settled after the fit, on the error count.
- A missing finder. Two are enough. A QR code is square, which leaves six discrete possibilities for the third — perpendicular from either end on either side, or the two being the diagonal pair. All six are fitted.
Vier Dinge ließen sich aus dem Bild schätzen, werden aber stattdessen aufgezählt: Eine falsche Schätzung bleibt unsichtbar, ein falscher Kandidat ist in den bekannten Zellen offensichtlich.
- Die Version. Jede Kandidatengröße erhält ihre eigene Gitteranpassung. Auf der Glühbirne hatte der Sieger 2 von 244 Zellen falsch, der Zweitplatzierte 69 — die Schätzung aus der Breite des Suchmusters war zwischen zwei Kandidaten gelandet.
- Die Auflösung. Ein Suchmuster ist sieben Module breit, daraus folgt die Modulgröße. Die Vorverarbeitung nimmt ungefähr neun Pixel je Modul an; außerhalb dieses Bereichs wird das Bild skaliert — in beide Richtungen. Ein Code kann daran scheitern, dass er zu gut fotografiert wurde.
- Die Polarität. Hell auf Dunkel lässt sich an den Suchmustern nicht entscheiden: Ein Suchmuster besteht aus ineinanderliegenden Quadraten, ebenso sein Negativ. Die Entscheidung fällt nach der Anpassung anhand der Fehlerzahl.
- Ein fehlendes Suchmuster. Zwei genügen. Ein QR-Code ist quadratisch; damit bleiben sechs diskrete Möglichkeiten für das dritte — senkrecht von jedem Ende auf jeder Seite oder die beiden als Diagonalpaar. Alle sechs werden angepasst.
06Ordered probingGeordnetes Nachtasten
When the matrix does not decode, the least certain cells are flipped — but in an order, and the order is the whole trick. Flipping a cell against its more likely reading costs its log-likelihood ratio:
Wenn sich die Matrix nicht decodieren lässt, werden die unsichersten Zellen umgedreht — aber in einer Reihenfolge, und diese Reihenfolge ist der ganze Trick. Eine Zelle gegen ihre wahrscheinlichere Lesart umzudrehen kostet ihr logarithmisches Likelihood-Verhältnis:
structure cells get cost ∞ and are never touchedeine Zelle mit p = 0.5 lässt sich kostenlos umdrehen · eine eindeutige ist teuer
Strukturzellen erhalten Kosten ∞ und werden nie verändert
Subsets of the cheapest cells are then enumerated in ascending total cost by a best-first search over a heap. Each subset already emitted spawns exactly two successors — extend it, or advance its last element — which yields every subset exactly once, in order.
Teilmengen der billigsten Zellen werden dann durch eine Best-First-Suche über einen Heap nach steigenden Gesamtkosten aufgezählt. Jede bereits ausgegebene Teilmenge erzeugt genau zwei Nachfolger — sie erweitern oder ihr letztes Element vorrücken. So erscheint jede Teilmenge genau einmal und in Reihenfolge.
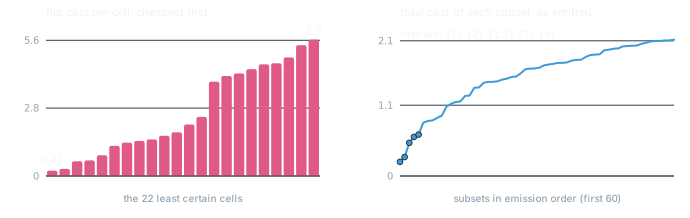
fixtures/engraved-curved-hard.png: the cheapest doubt costs 0.22 against 5.6 for the twenty-second, a factor of twenty-five. So the order is not a detail — enumerating the same cells in any other order would spend the whole budget on combinations that were never plausible. The right panel is the property the heap guarantees: the total cost never decreases from one emission to the next.Die Leiter und die Reihenfolge, in der sie erklommen wird. Gemessene Kosten auf fixtures/engraved-curved-hard.png: Der billigste Zweifel kostet 0.22 gegenüber 5.6 für den zweiundzwanzigsten, ein Faktor von fünfundzwanzig. Die Reihenfolge ist also kein Detail — dieselben Zellen anders aufzuzählen würde das gesamte Budget für nie plausible Kombinationen ausgeben. Das rechte Diagramm zeigt die Garantie des Heaps: Die Gesamtkosten sinken von einer Ausgabe zur nächsten nie.
07Reed-Solomon and erasuresReed–Solomon und Auslassungen
Codewords are bytes in GF(2⁸) with primitive polynomial 0x11D. A block of n codewords carries t check symbols, and the decoder can repair
Codewörter sind Bytes in GF(2⁸) mit dem primitiven Polynom 0x11D. Ein Block aus n Codewörtern trägt t Prüfsymbole, und der Decoder kann Folgendes reparieren:
an erasure costs one, because its position is already knownein Fehler kostet zwei Prüfsymbole — eines zum Finden, eines zum Korrigieren
eine Auslassung kostet eines, weil ihre Position bereits bekannt ist
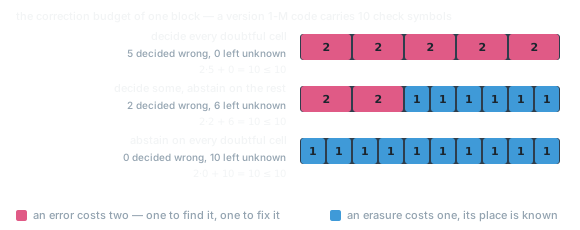
That factor of two is why the module matrix has three states rather than two. An honest "I don't know, but I know where" is worth twice a guess.
The chain: syndromes Si = r(αi) tell whether the block is intact. Forney syndromes remove the known erasures first — without that step Berlekamp-Massey goes looking for them again as unknown errors and fails. What is left is located by Berlekamp-Massey and Chien search, and the magnitudes come from Forney's formula.
Valid is not the same as correct
With as many erasures as check symbols, Reed-Solomon always finds a valid solution. If the real errors lie outside the erased positions, that solution is cleanly computed and wrong. So the erasure count is raised one step at a time and the sparsest result that an outside check accepts is taken. Without that contradiction from outside, the method returns something every time, and usually nonsense.
Prefixes are not enough either
Raising the count erases the k least reliable codewords — a prefix of the reliability order. Measured on real photographs, the damaged codewords interleave with sound ones in that order, and every sound codeword inside the prefix is a check symbol spent on nothing. Damage at reliability ranks {2,4,6,8,10,12,14,16,18} is unreachable for any prefix — covering rank 18 costs 18 of 15 symbols — while the exact set costs 9. So after the ladder fails, arbitrary erasure sets are enumerated in ascending total doubt, by the same heap that orders the cell probe in §06. Each candidate still has to survive the outside check.
Dieser Faktor zwei ist der Grund, warum die Modulmatrix drei Zustände statt zwei hat. Ein ehrliches „Ich weiß es nicht, aber ich weiß wo“ ist doppelt so viel wert wie eine Vermutung.
Die Kette: Syndrome Si = r(αi) zeigen, ob der Block intakt ist. Forney-Syndrome entfernen zuerst die bekannten Auslassungen — ohne diesen Schritt sucht Berlekamp–Massey sie erneut als unbekannte Fehler und scheitert. Der Rest wird durch Berlekamp–Massey und Chien-Suche lokalisiert, die Größen liefert Forneys Formel.
Gültig ist nicht dasselbe wie korrekt
Bei ebenso vielen Auslassungen wie Prüfsymbolen findet Reed–Solomon immer eine gültige Lösung. Liegen die wirklichen Fehler außerhalb der ausgelassenen Positionen, wird diese Lösung sauber berechnet und ist falsch. Deshalb wird die Zahl der Auslassungen schrittweise erhöht und das dünnste Ergebnis genommen, das eine äußere Prüfung akzeptiert. Ohne diesen Widerspruch von außen liefert das Verfahren jedes Mal etwas — und meist Unsinn.
Präfixe genügen ebenfalls nicht
Eine höhere Zahl löscht die k unzuverlässigsten Codewörter — ein Präfix der Zuverlässigkeitsreihenfolge. Auf echten Fotos gemessen wechseln beschädigte und intakte Codewörter in dieser Reihenfolge einander ab, und jedes intakte Codewort im Präfix verschwendet ein Prüfsymbol. Schäden auf den Zuverlässigkeitsrängen {2,4,6,8,10,12,14,16,18} sind für jedes Präfix unerreichbar — Rang 18 abzudecken kostet 18 von 15 Symbolen — während die exakte Menge 9 kostet. Scheitert die Leiter, werden deshalb beliebige Mengen von Auslassungen nach steigendem Gesamtzweifel aufgezählt, durch denselben Heap, der das Nachtasten der Zellen in §06 ordnet. Jeder Kandidat muss weiterhin die äußere Prüfung bestehen.
08Where it stopsWo es endet
Measured on synthetic cases with known answers, under otherwise ideal conditions, the limit is resolution:
An synthetischen Fällen mit bekannten Antworten gemessen ist unter ansonsten idealen Bedingungen die Auflösung die Grenze:
| pixels per modulePixel je Modul | recoveredrekonstruiert |
|---|---|
| 6.0 | 5 / 5 |
| 5.0 | 5 / 5 |
| 4.0 | 1 / 5 |
| 3.0 | 0 / 5 |
Below about five pixels per module the information is not in the image, and no amount of modelling puts it back. Real damage moves that threshold upward, never down.
On thirteen genuinely damaged codes, of which a plain decoder reads one, qrsalvage recovers six and places the grid cleanly on nine. The ones it does not recover mostly fail because too many data modules are physically gone — the method can find and place a code well past the point where it can read one.
Unter ungefähr fünf Pixeln je Modul ist die Information nicht im Bild vorhanden, und kein noch so aufwendiges Modell bringt sie zurück. Reale Schäden verschieben diese Schwelle nach oben, niemals nach unten.
Von dreizehn wirklich beschädigten Codes, von denen ein gewöhnlicher Decoder einen liest, rekonstruiert qrsalvage sechs und platziert bei neun das Gitter sauber. Die nicht rekonstruierten Fälle scheitern meist, weil physisch zu viele Datenmodule fehlen — das Verfahren kann einen Code noch lange finden und platzieren, nachdem es ihn nicht mehr lesen kann.